智识文档通v1.0.0相关功能介绍
你有没有过这样的经历?
桌上堆着一摞发票、合同、火车票、银行回单,老板说“下班前录进Excel”。你打开电脑,一边眯着眼辨认模糊的票号,一边疯狂敲键盘,手指抽筋,眼睛发花,好不容易录完一半,发现有一张发票的税额填错了,又得回头一张张核对……
这种苦日子,到头了。
智识文档通 v1.0.0,正式登场。
它不是OCR,它是你的“文档理解外挂”
别被“OCR”三个字骗了。传统OCR是什么?是把图片里的字一个个抠出来,至于这些字是什么意思、属于哪个字段、该填到表格哪一列——它不管。
智识文档通不一样。它背后是 DeepSeek 多模态视觉大模型,能看懂文档的“语义”。你扔给它一张增值税发票,它不光识别出所有文字,还知道哪个是发票代码、哪个是价税合计、销售方是谁、购买方是谁。你扔给它一份合同,它自动提取甲方乙方、签订日期、合同金额、有效期。你扔给它一张荣誉证书,它连“颁发单位”“获奖人”“正文摘要”都给你安排得明明白白。
27种标准文档类型 + 无限开放式自由命名,覆盖增值税发票、火车票、飞机行程单、出租车票、定额发票、银行回单、银行支票、银行汇票、身份证、户口本、荣誉证书、合同、通知、任命书、证明、简历、报告、申请、收据、介绍信、委托书、邀请函……以及任何你随手拍下的、叫不出名字的文档。
你不需要告诉它“这是什么类型”。它自己会判断。识别完,自动归类到对应的Tab页,表格列名自动匹配该类型的核心字段。你唯一要做的,就是把文件拖进去,点“开始识别”。
手机拍,电脑收,二维码一扫全搞定
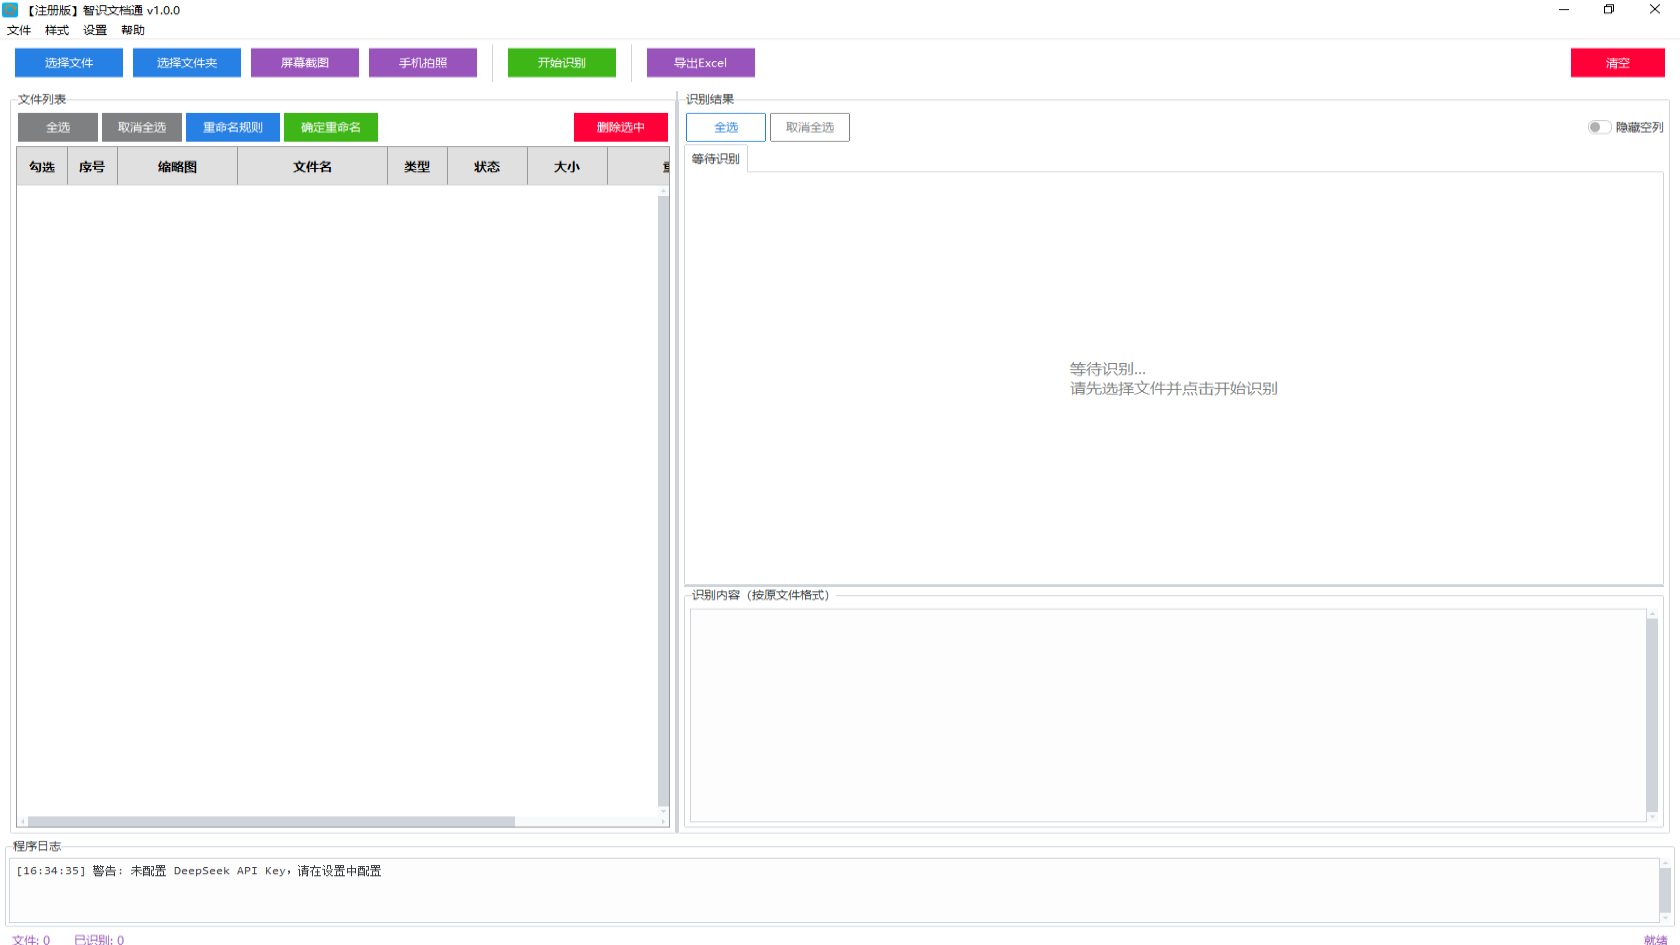
以前扫描文件,要么用扫描仪,要么用数据线把手机照片传到电脑。现在?点一下工具栏的“手机拍照”按钮,电脑屏幕上弹出一个二维码。手机扫码,浏览器打开拍照页面,对准纸质文档“咔嚓”一声——照片自动飞进电脑的文件列表。
同一WiFi下,想拍多少张拍多少张。电脑端实时显示“已接收X张”和缩略图网格。拍完点“关闭”,回到主界面点“开始识别”,批量处理。手机当扫描仪,电脑当工作站,中间不需要一根线。
个人模板:你要什么字段,AI就提什么字段
更骚的操作在这里。如果你有一批格式特殊的表格,系统预定义字段不够用怎么办?用“个人模板”功能。
截图框选表头 → AI识别列名 → 直接作为模板字段。识别时把字段列表动态传给AI,AI只提取你指定的字段。你要“金额”它就提“金额”,你要“摘要”它就提“摘要”,你要“备注”它就提“备注”。 AI做翻译,代码做计算,各司其职,完美配合。
细节拉满,爽感翻倍
结果面板可拖拽:上下面板之间加分割条,鼠标悬停变上下箭头,按住拖拽调整高度。想看大表格就拉大上面,想看详细内容就拉大下面。
列宽自适应:中文按15px、英文按8px智能计算,内容多的前两列自动拉伸填满,内容少的紧凑排列。再也不用手动拖列宽。
全选/取消全选:一键勾选所有识别结果,批量导出,批量操作。
弹窗居中:所有提示框、确认框、设置对话框,统统居中到主窗口。不再从屏幕左上角闪出来吓你一跳。
PDF自动预渲染:PDF文件自动用PyMuPDF渲染第一页2倍缩放缩略图,点击缩略图用6倍缩放预览。火车票上的小字,放大看清清楚楚。
框选截屏:全屏蒙层+鼠标拖拽框选,截哪识别哪。屏幕上看到的任何内容,框一下就能识别。
勾选可视化:☑和☐,一眼看清哪些选了哪些没选。告别空字符串渲染空白导致的“以为没渲染”的尴尬。
性能与成本,都替你算好了
单张图片识别约 2-5秒,比百度OCR多接口轮询快得多。
图片预处理自动缩放至最长边2048px,JPEG质量逐级降级(85→75→60→45→30),确保不超过DeepSeek 48MB请求体限制。
模型自动发现:GET /models 筛选flash系列,24小时缓存,失败fallback硬编码deepseek-flash。模型下线?不存在的,自动路由到最新版。
按token计费,flash模型输入¥2.00/百万tokens,输出¥8.00/百万tokens,一张图约384 tokens。识别一万张发票的成本,可能还不够你喝一杯咖啡。
最后说一句
智识文档通不是“又一个OCR工具”。它是一个文档理解中枢——把任意格式、任意类型的文档图片,变成结构化数据,自动归类、自动填表、自动导出Excel。它把“人工录入”这件事,从你的待办清单里彻底划掉。
你负责拍照,它负责理解。你负责点按钮,它负责干完所有活。
下载、安装、填入DeepSeek API Key、拖入文件、点“开始识别”。五步之后,你会发现:原来下班前录完所有票据,真的可以做到。
智识文档通 v1.0.0,让文档自己开口说话。